מאחורי הקלעים של ענקיות ה-AI
12.4.2026

בקצרה
- טוקנים, יחידות הטקסט הקטנות ביותר, משמשים מודלי AI לעיבוד מידע, בדומה לחלוקת הודעות בוואטסאפ, כאשר מגבלת הטוקנים קובעת את כמות המידע שהמודל יכול לעבד בו זמנית, דבר המשפיע על יעילות התפעול ועלויות השימוש.
- מודלים של AI מתומחרים לפי צריכת טוקנים, כאשר Claude 4.6 Opus של Anthropic ו-GPT 5.4 של OpenAI הם מהיקרים ביותר, עם עלויות של 5 דולר לקלט ו-25 דולר לפלט, ו-2.5 דולר לקלט ו-15 דולר לפלט בהתאמה, מה שמצריך ניהול יעיל של טוקנים.
- הבנת מגבלת הטוקנים מאפשרת ניסוח הנחיות ממוקדות וקיצור שאלות, דבר המשפר את דיוק המודל ומונע אובדן מידע קריטי בשיחות ארוכות, במיוחד לאור העובדה שכל תגובה חדשה דוחקת החוצה טוקנים ישנים, ומשפיעה על יכולת המודל לשמור על הקשר.
- עבודה יעילה עם מודלי AI דורשת שימוש בטכניקות כמו סיכום עצמי של טקסטים ארוכים לפני העלאתם למודל, במטרה לחסוך טוקנים מיותרים ולהבטיח שהמודל יתמקד בפרטים המהותיים, דבר המשפר את ביצועי המודל ומקטין עלויות.
ההתפתחות המואצת של מודלי השפה הגדולים מציבה את הטוקנים כיחידת הערך המרכזית בכלכלה הדיגיטלית החדשה.
הבנת המנגנון העומד בבסיס יחידות המידע הללו חיונית למיקסום יעילות תפעולית, ולשמירה על יתרון תחרותי בשוק ההון הטכנולוגי.
סיקרתי בשבילכם את המשמעות הכלכלית של הטוקן ואת השפעתו המכרעת על יכולות הביצוע של חברות הענק.
אז מהו טוקן?
הטוקנים הם יחידות הטקסט הקטנות ביותר שאליהן מפרקים מודלי הבינה המלאכותית כל הודעה לצורך עיבוד והבנה של התוכן.
ניתן להקביל זאת לאופן שבו שירותי תקשורת כמו וואטסאפ מחלקים הודעות לחלקים קטנים לצורך שידור יעיל, כאשר המודל מפצל את הטקסט למילים, חצאי מילים ואף סימני פיסוק נפרדים.
מגבלת הטוקנים היא הגורם הקובע כמה מידע מסוגל המודל לעבד בבת אחת, והבנה מעמיקה של מושג זה מאפשרת לארגונים לנסח הנחיות יעילות יותר, לשלוט בעלויות ולמנוע איבוד מידע קריטי במהלך שיחות ארוכות שבהן חלקים מההודעה עלולים להישכח.
טוקן מייצג חתיכה קטנה של טקסט המאפשרת למודל לעכל את הנתונים, ובמקום לקרוא משפטים כמקשה אחת, המערכת קולטת רצף של חלקיקים ומחשבת מהם את התשובה הרצויה.
ככל שכמות הטוקנים גדלה, נדרש מהמודל מאמץ מחשבתי וזמן עיבוד רב יותר, ולכן המגבלה המדוברת מתייחסת לגודל חבילת החלקיקים שהמערכת מסוגלת לנהל בסבב עיבוד יחיד.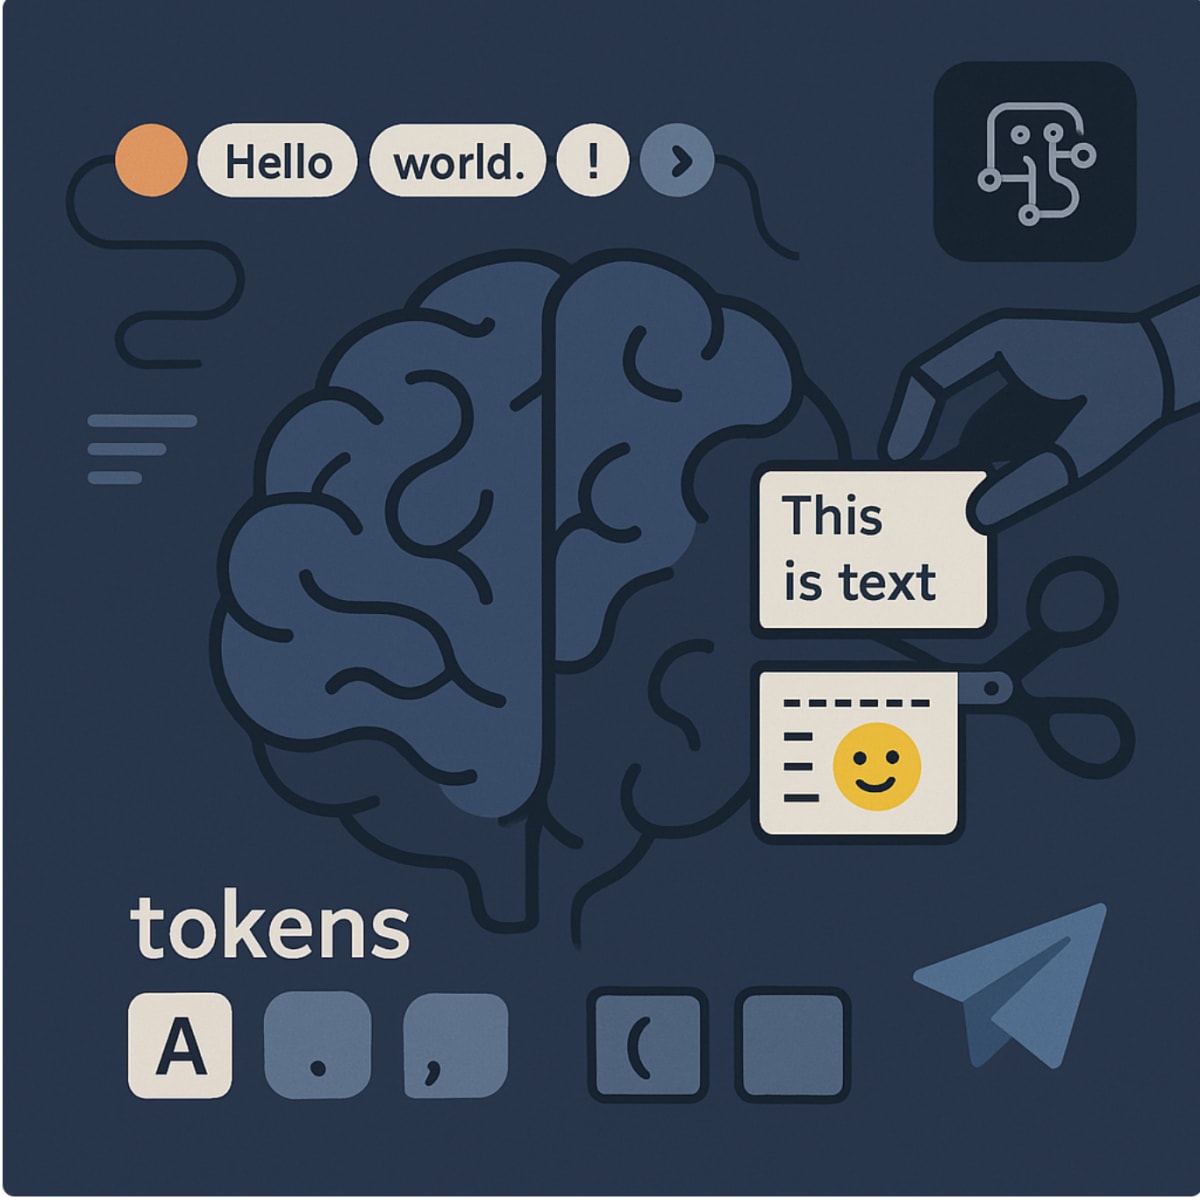
קרדיט: academAI
המנגנון, ואיך הכל עובד?
פעולת הטוקנים דומה לבניית טירה מקוביות לגו, שבה לא מרימים חומה שלמה בבת אחת אלא מחברים קובייה לקובייה עד ליצירת מבנה ברור.
הטוקנים הם אותן קוביות המהוות את היחידות הפשוטות ביותר שעליהן נשענת התמונה המפוארת שהמודל מייצר בסוף התהליך.
הוספת משפט להנחיה היא זהה להוספת שקית קוביות חדשה, והמודל בונה מהן תשובה מפורטת, אך הצפה של השולחן ב״קוביות״ רבות מדי מאטה את קצב הבנייה ועלולה להוביל לקריסת הזיכרון הפנימי.
בעת הדבקת מאמר לתוך ChatGPT של חברת OpenAI לדוגמא, המערכת אינה סופרת מילים, אלא טוקנים, החל מהכותרת ועד לכל נקודה ולכל רווח.
כאשר הסכום הכולל מתקרב לתקרת הזיכרון, המודל נאלץ לבחור איזה מידע יישאר ואיזה יימחק כדי לפנות מקום לתשובה החדשה.
תופעה זו ניכרת היטב במודל Claude של חברת Anthropic, שם ניסיון לנתח חוזים ארוכים במיוחד מוביל לבקשות קיצור או לדילוג על סעיפים, שכן שעון החול של הטוקנים אינו ניתן להגדלה רגעית באמצע תהליך העבודה.
בעצם, דמיינו לכם שיש גבול לכמה המודל יכול להכיל ולעבד בטקסט אחד.
ככה צריכה להיות אסטרטגיית העבודה שלנו
הכרה בסיסית של עולם הטוקנים מסייעת בניסוח הנחיות ממוקדות המונעות חיתוך של מידע חיוני ומשפרת את הדיוק של המודל.
הבנת המגבלות מאפשרת לקצר או לפצל שאלות כדי לשמור על רלוונטיות גבוהה, במיוחד לאור העובדה שתמחור שירותי AI רבים מבוסס על צריכת הטוקנים בפועל.
בשיחות ארוכות בתוך ChatGPT, כל תגובה חדשה דוחפת החוצה את הטוקנים הוותיקים ביותר, מה שעלול לגרום למודל לשכוח את הטון המקורי או את ההנחיות הקריטיות שניתנו בתחילת הדרך.
במודלים ויזואליים, הדבר בא לידי ביטוי בהיעלמות של פרטים קטנים מתיאור התמונה לטובת פינוי מקום לטוקנים המתארים תאורה או אפקטים חדשים.
עבודה יעילה דורשת גישה של עורך וידאו הממוקד בעיקר, תוך שימוש בטכניקות כמו סיכום עצמי של טקסטים ארוכים לפני הדבקתם כדי לחסוך טוקנים מיותרים.
לדוגמה, בשימוש במודל Claude, מומלץ לבקש תקציר דחוס השומר על הפרטים המהותיים ורק לאחר מכן להמשיך בעיבוד, מה שמאפשר להחליף ערימות של טוקנים יקרים בחבילה מצומצמת ויעילה שאינה מכבידה על הזיכרון.
מי חברת ה-AI שהכי יעילה בשימוש הטוקנים?
התמחור בשוק הבינה המלאכותית נמדד לרוב לפי יחידות של מיליון טוקנים, כאשר קיימת הבחנה ברורה בין עלות הקלט (Input) לעלות הפלט (Output).
נכון להיום, המודלים היקרים והחזקים ביותר הם Claude 4.6 Opus של חברת Anthropic עם עלות של 5 דולרים לקלט ו 25 דולרים לפלט, ו GPT 5.4 של OpenAI המציע עלויות דומות סביב 2.5 דולרים לקלט ו 15 דולרים לפלט.
בדרג הביניים ניתן למצוא את Claude 4.6 Sonnet בעלות של 3 דולרים לקלט ו 15 דולרים לפלט, המהווה איזון איכותי למחיר.
המודלים החסכוניים ביותר בשוק כיום הם GPT 5.4 mini בעלות זניחה המתחילה ב 0.15 דולרים, וכן Gemini 3 Flash של גוגל המציע מחירים תחרותיים במיוחד של 0.15 עד 0.50 דולרים לקלט.
חידוש משמעותי בשוק הוא מנגנון ה Cache Control (שיטה לאחסון זמני של נתונים במיקום נגיש ומהיר, במטרה לקצר את זמני הטעינה ולשפר את ביצועי המערכת על ידי שליפה מהירה של מידע שכבר היה בשימוש) המאפשר חיסכון של עד 90% בעלויות הקלט על ידי שמירת חלקים קבועים מהפרומפט בזיכרון המטמון, מה שמוריד את עלות ה Cache Read לרמות שבין 0.075 ל 0.50 דולרים בלבד במודלים השונים.
המשתמש הפרטי אמנם אינו משלם על כל טוקן בנפרד בגרסאות החינמיות, אך החברות סופגות עלויות עצומות של חשמל ועיבוד בשרתים ומממנות זאת דרך מנויי פרימיום ומכירות API לארגונים.
לא רק חברות בינה מלאכותית
חברות רבות מחוץ לעולם הטכנולוגיה הטהור משלבות טוקנים בתהליכי הליבה שלהן כדי לייצר יעילות חסרת תקדים.
חברת (Opendoor (OPEN הפועלת בתחום הנדל"ן, משתמשת במנועי תמחור מבוססי AI המנתחים מאות אלפי תמונות ונתוני שוק, כאשר כל הערכת נכס צורכת אלפי טוקנים המפורקים ממאפייני הבית ועלויות התחזוקה.
חברת (Duolingo (DUOL מעבדת מעל טריליון טוקנים בחודש דרך OpenAI כדי לספק שיעורי שפה בהתאמה אישית למיליוני משתמשים בזמן אמת.
בפלטפורמת (Shopify (SHOP, הטוקנים משמשים לייצור אוטומטי של תיאורי מוצרים וקמפיינים שיווקיים עבור המוכרים, ובכך חוסכים אלפי שעות עבודה.
גם חברת Canva נעזרת בטוקנים דרך Magic Studio ליצירת עיצובים וויזואליים מבוססי טקסט, בעוד שחברת (Salesforce (CRM מטמיעה את Einstein Copilot לניתוח אינטראקציות עם לקוחות וסיכום פגישות עסקיות בקנה מידה רחב.
השימוש המסיבי בטוקנים הופך אותם לדלק האמיתי של התעשייה המודרנית, כאשר חברות אלו מחפשות כל העת דרכים לאופטימיזציה של הצריכה כדי לשפר את שורת הרווח.
ניצול הטוקנים לצמיחה עסקית
עולם הבינה המלאכותית מבוסס על הבנת המטבע הקטן שבונה את הדיאלוג הגדול.
היכולת של מנהלים ואנליסטים להבין את מגבלות הטוקנים ואת עלויותיהם היא זו שתקבע את היעילות הכלכלית של הטמעת מערכות AI בארגון.
ככל שהשוק מתקדם לעבר מודלים חסכוניים יותר ושימוש בטכנולוגיות Caching, הכוח עובר לידיים של אלו שיודעים לנהל את המידע בצורה מזוקקת ומדויקת.
השורה התחתונה ברורה, הבנת הטוקנים היא אינה רק צורך טכני, אלא הכרח אסטרטגי לכל מי שמעוניין להוביל בעידן הבינה המלאכותית.