האימון היה רק ההתחלה וההסקה תהיה מנוע הביקוש הבא של תשתיות הAI
2.9.2026
בקצרה
- ההתמקדות הנוכחית בתשתיות AI סביב אימון מודלים צפויה לעבור לשלב ההסקה, שבו המודלים המאומנים מופעלים לשימוש יומיומי, מה שמעיד על שינוי במוקד ההשקעות מתשתיות בנייה לתשתיות הפעלה מתמשכת.
- הסקה, בניגוד לאימון שהוא תהליך מרוכז וחד-פעמי יחסית, מייצגת עומס מחשובי חוזר ומתמשך הגדל עם מספר המשתמשים והבקשות, מה שמבטיח ביקוש יציב ומתגבר למעבדים, זיכרונות ותשתיות קירור לאורך זמן.
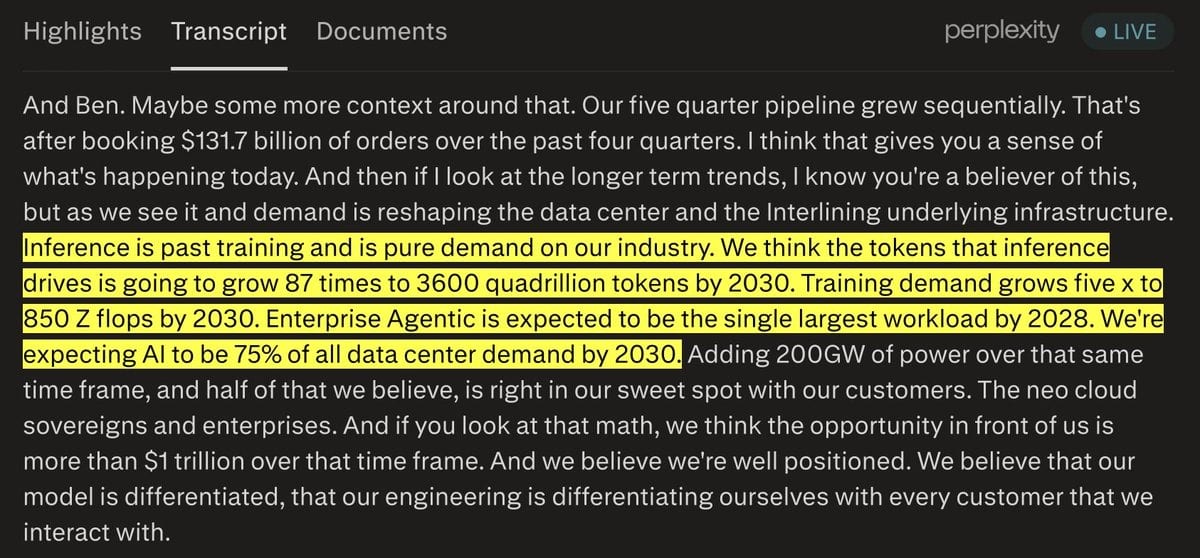
- חברת Dell צופה גידול אדיר של פי 87 במספר הטוקנים המעובדים בהסקה עד שנת 2030, שיגיע ל-3,600 קוודריליון טוקנים, מה שמצביע על צמיחה אקספוננציאלית בביקוש למשאבי מחשוב עבור הפעלת מודלי AI.
- סוכני AI מגבירים באופן משמעותי את צריכת המחשוב בהסקה, מכיוון שמשימה אחת למשתמש יכולה לכלול עשרות פעולות פנימיות ועיבוד מיליוני טוקנים, מה שיוצר פער עצום בין בקשות המשתמש לבין העומס בפועל על התשתיות.
בשנים האחרונות כמעט כל הדיון סביב תשתיות בינה מלאכותית התמקד באימון המודלים. חברות הטכנולוגיה רכשו מאות אלפי מעבדים, הקימו מרכזי נתונים והגדילו במהירות את ההשקעות בחשמל, תקשורת וקירור כדי לבנות מודלים גדולים וחכמים יותר. החשש של חלק מהמשקיעים הוא שברגע שהמודלים המרכזיים כבר אומנו, גל ההשקעות יגיע לשיא והביקוש לתשתיות יתחיל להתמתן.
אלא שהאימון הוא רק השלב שבו בונים את המודל. לאחר מכן מתחיל השימוש בו, וכאן נכנסת לתמונה ההסקה. בכל פעם שמשתמש שואל שאלה, חברה מנתחת מסמך, מערכת יוצרת תמונה או סוכן AI מבצע משימה, המודל צריך לפעול מחדש ולבצע חישובים. ככל שמספר המשתמשים גדל וככל שכל משתמש מבקש מהמודל לבצע יותר עבודה, הביקוש למחשוב חוזר שוב ושוב.
זו הסיבה שהאמירה של הנהלת Dell במהלך שיחת המשקיעים שנערכה הלילה לאחר דיווח התוצאות של Q2 2026 משכה תשומת לב.
החברה מעריכה שהשלב הבא של התפתחות הAI לא יתבסס רק על בניית מודלים טובים יותר, אלא בעיקר על הפעלתם בהיקפים עצומים. אם התחזית הזאת תתקרב למציאות, ההזדמנות לא תישאר אצל Dell בלבד. היא עשויה להתפזר על פני שרשרת שלמה של מעבדים, זיכרונות, שבבי תקשורת, אחסון, רשתות, שרתים, מערכות קירור ותשתיות חשמל.
מה ההבדל בין אימון להסקה
אימון הוא התהליך שבו מודל בינה מלאכותית לומד מתוך כמויות גדולות של מידע. במהלך האימון המערכת מקבלת דוגמאות, משווה בין התוצאה שהפיקה לבין התוצאה הרצויה ומעדכנת שוב ושוב את הפרמטרים שלה.
התהליך הזה דורש כוח מחשוב עצום. אלפי מעבדים יכולים לעבוד יחד במשך שבועות או חודשים כדי לאמן מודל גדול. לכן אימון מתבצע בדרך כלל באשכולות מחשוב גדולים ומרוכזים, שבהם המעבדים צריכים לתקשר ביניהם במהירות גבוהה מאוד.
הסקה היא מה שקורה לאחר שהמודל כבר אומן, זה השלב שבו משתמשים במודל כדי לקבל תשובה, תחזית, תמונה, קוד או החלטה. כאשר אדם פונה לצ׳אט ומבקש ממנו לסכם מסמך, המודל אינו לומד מחדש מאפס. הוא מפעיל את הידע שכבר נבנה בתוכו ומחשב מה תהיה התשובה המתאימה.
אפשר לחשוב על אימון כמו בניית מפעל ועל הסקה כמו הפעלת קווי הייצור בתוכו. בניית המפעל היא פרויקט גדול ויקר, אך הייצור עצמו מתרחש בכל פעם שלקוח מבצע הזמנה. אם מספר ההזמנות גדל, המפעל צריך לעבוד יותר שעות, לעבד יותר חומר ולצרוך יותר חשמל.
אימון הוא עומס גדול אך מרוכז יחסית, הסקה היא עומס חוזר שגדל עם מספר המשתמשים, מספר הבקשות, מורכבות המשימות ואורך התשובות. מודל יכול לעבור אימון מרכזי אחת לתקופה, אבל לבצע מיליארדי פעולות הסקה לאחר שהוא מגיע לשימוש מסחרי.
בתמונה למטה מסומן המשפט מתוך שיחת המשקיעים של Dell שמעריכים שמספר הטוקנים המעובדים במסגרת הסקה עשוי לגדול פי 87 ולהגיע ל3,600 קוודריליון טוקנים עד 2030 (מספר הזוי פשוט).
קוודריליון הוא מיליון מיליארדים, או אלף טריליונים. המשמעות היא תחזית לכ3.6 מיליארד מיליארדים של טוקנים. המספר כמעט בלתי נתפס, אך הרעיון החשוב אינו השם של המספר אלא קצב הגידול הצפוי בכמות המידע שהמודלים יצטרכו לקרוא ולייצר.
מקור: Perplexity
למה סוכני AI יכולים להקפיץ את צריכת המחשוב
טוקן הוא יחידת המידע הבסיסית שהמודל קורא או מייצר. מילה אחת יכולה להיות מורכבת מטוקן אחד או מכמה טוקנים, בהתאם לשפה ולמבנה המילה. העלות והעומס של הפעלת מודל מושפעים בין היתר ממספר הטוקנים שהוא צריך לעבד.
בצ׳אט רגיל המשתמש כותב שאלה והמודל מייצר תשובה, אבל בסוכן AI התהליך מורכב בהרבה.
הסוכן יכול לקרוא מסמך, לחפש מידע, להפעיל תוכנה, לבחון את התוצאה, לזהות טעות ולנסות שוב. בכל שלב הוא עשוי לקרוא מחדש חלק מהמידע שכבר נאסף ולשלב אותו עם תוצאות חדשות.
משימה שנראית למשתמש כמו בקשה אחת יכולה להפוך מאחורי הקלעים לעשרות פעולות נפרדות. כאשר כמה סוכנים עובדים יחד, כל אחד מהם יכול לקבל תפקיד אחר ולהחליף מידע עם האחרים. כך נוצר פער גדול בין מספר הבקשות שהמשתמש רואה לבין מספר החישובים שמתבצעים בפועל.
בניסוי שהתקיים במסגרת Dell Technologies World, יותר מ200 משתתפים הפעילו סוכנים במשך 13 שעות. המערכות עיבדו 164 מיליון טוקנים של קלט, כלומר מידע שנקרא על ידי המודלים, לעומת כ562 אלף טוקנים של פלט, כלומר התוכן שהמודלים יצרו. הפער ממחיש עד כמה עבודה של סוכן יכולה להיות כבדה בצד הקריאה והעיבוד, גם כאשר התשובה הסופית קצרה יחסית.
Dell מעריכה שסוכני AI בארגונים עשוי להפוך לעומס העבודה הגדול ביותר במרכזי הנתונים עד 2028. זו תחזית של החברה ולא עובדה ודאית, אך ההיגיון שמאחוריה ברור. ככל שהAI עובר מכלי שעונה על שאלות למערכת שמבצעת עבודה מתמשכת, כמות החישובים הנדרשת לכל משתמש יכולה לגדול בצורה משמעותית.
אגב אנחנו ממש רואים את המהפכה הזאת קורית לנו מול העיניים, התחלנו עם Chat GPT ומודלים נוספים שרק ענו לנו על שאלות והתקדמנו לסוכני AI שממש מבצעים עבורנו דברים ובכל כמה שבועות יוצא משהו חדש. רק לפני כמה ימים הושק Grok Bot שבאמת שובר שיאים חדשים.
בואו נדבר על כמה חברות מסקטורים ותתי סקטורים שונים שיכולות ליהנות באופן ישיר מביקוש להסקה שרק הולך וגדל.
המעבדים שמבצעים את החישובים
NVIDIA וAMD נמצאות בשכבה הישירה ביותר של התזה. הן מוכרות מאיצי חישוב שמריצים את המודלים ומבצעים את פעולות ההסקה. ככל שהמודלים משרתים יותר משתמשים, מעבדים יותר טוקנים ומבצעים יותר שלבי חשיבה, נדרשת קיבולת חישוב גדולה יותר.
הסקה אינה מחייבת תמיד את המאיץ החזק והיקר ביותר. משימות פשוטות יכולות לרוץ על מעבדים יעילים וזולים יותר, בעוד שמודלים גדולים או יישומים שדורשים תגובה מהירה עשויים להצדיק מערכות מתקדמות. לכן הצמיחה בהסקה יכולה להרחיב את השוק הכולל וגם ליצור ביקוש למגוון גדול יותר של מעבדים.
NVIDIA נהנית ממערכת רחבה הכוללת מעבדים, תקשורת ותוכנה.
AMD מנסה להגדיל את חלקה באמצעות מאיצים ופתרונות למרכזי נתונים.
בשני המקרים החשיפה ישירה יחסית, אך התוצאה העסקית תלויה בתחרות, במחירים, בקצב אספקת המוצרים וביכולת הלקוחות לשפר את ניצול החומרה שכבר רכשו.
השבבים המותאמים שמנסים להוזיל את עלות ההסקה
MRVL AVGO פועלות בשני תחומים חשובים. הן מסייעות לחברות ענן לפתח שבבים מותאמים לצרכים שלהן ומספקות רכיבי תקשורת שמאפשרים למערכות החישוב להעביר מידע במהירות.
שבב מותאם מיועד לבצע משימה מסוימת בצורה יעילה יותר משבב כללי. כאשר חברת ענן מפעילה מיליארדי בקשות דומות, אפילו חיסכון קטן בעלות של כל בקשה יכול להפוך לחיסכון משמעותי. לכן הצמיחה בהסקה עשויה להגביר את המוטיבציה של חברות גדולות לפתח מאיצים ייעודיים.
מבחינת NVIDIA וAMD, המעבר לשבבים ייעודיים הוא גם הזדמנות וגם איום. השוק הכולל יכול לגדול, אך חלק גדול יותר ממנו עשוי לעבור לפתרונות מותאמים.
MRVL AVGO עשויות ליהנות מהמגמה באמצעות תכנון השבבים ורכיבי התקשורת, בלי שהן צריכות להיות בעלות המודל או ספקיות הענן.
מי שמייצרת את השבבים ומי שמספקת את התכנון
TSMC נמצאת מאחורי חלק גדול מהשבבים המתקדמים של תעשיית הבינה המלאכותית. היא לא מפתחת בדרך כלל את המאיץ הסופי, אלא מייצרת שבבים שתוכננו על ידי חברות אחרות. אם הביקוש למאיצים ולשבבים מותאמים יגדל, הוא עשוי להתגלגל להזמנות נוספות לייצור מתקדם ולאריזה מתקדמת.
אריזה מתקדמת היא הדרך שבה מחברים כמה רכיבי חישוב וזיכרון למערכת אחת צפופה ומהירה. ככל שהמעבדים הופכים מורכבים יותר, האריזה עצמה הופכת לצוואר בקבוק חשוב ולא רק שלב טכני בסוף הייצור, והחברות שמעניינות בתת הסקטור הזה הן AMAT ו-ONTO אך גם CAMT (שלא מבצעת בדיוק את האריזה המתקדמת אלא מוכרת מערכות בדיקה שמשמשות את חברות האריזה) רלוונטית בעקבות הגידול של ביקוש להסקה
ARM נמצאת בשלב מוקדם יותר של שרשרת הערך. היא מוכרת רישיונות לתכנוני מעבדים ומקבלת תמלוגים על שבבים המבוססים על הטכנולוגיה שלה. ככל שיותר מעבדים במרכזי נתונים ובמערכות הסקה יתבססו על ארכיטקטורת ARM, החברה עשויה ליהנות מגידול במספר הרישיונות והשבבים. החשיפה שלה תלויה בהחלטות התכנון של הלקוחות ולא רק בגידול הכללי במחשוב.
הזיכרון קובע כמה מידע ניתן לעבד במהירות
MU מספקת זיכרונות HBM וDRAM. זיכרון HBM הוא זיכרון בעל רוחב פס גבוה, שמסוגל להעביר כמויות גדולות של מידע במהירות בין הזיכרון למעבד. DRAM הוא זיכרון העבודה שבו המערכת מחזיקה מידע שנדרש באופן מיידי.
במהלך ההסקה המודל צריך להיות זמין בזיכרון, יחד עם השיחה, המסמכים והמידע שהמערכת מעבדת. כאשר מספר המשתמשים במקביל עולה, השיחות מתארכות והמודלים גדלים, הדרישה לקיבולת זיכרון ולמהירות העברת מידע יכולה לעלות.
המשמעות היא שהביקוש להסקה אינו נמדד רק במספר המעבדים. מערכת עם מעבד חזק אך עם מעט מדי זיכרון או קצב העברת מידע נמוך לא תוכל לנצל את מלוא כוח החישוב שלה.
אחסון מהיר ואחסון בנפח גדול
MU ו-SNDK מספקות זיכרון NAND וכונני SSD. בניגוד לזיכרון העבודה, שמחזיק מידע שנדרש מיד, האחסון שומר את המודלים, מאגרי המידע ותוצאות העבודה לטווח ארוך יותר.
יישומי הסקה ארגוניים עשויים להשתמש במערכות שמחפשות מידע במסמכי החברה לפני יצירת תשובה. ככל שכמות המסמכים, המודלים והמידע שנאסף גדלה, עולה הצורך באחסון מהיר שמסוגל לשלוף את המידע בזמן קצר.
כל המידע צריך לעבור בין הרכיבים
CRDO ALAB פועלות בשכבת החיבוריות.
Astera Labs מספקת רכיבים שמחברים בין מעבדים, זיכרונות ורכיבים אחרים בתוך מערכות מחשוב. Credo מספקת שבבי תקשורת וכבלים חשמליים פעילים שמאפשרים להעביר מידע במהירות גבוהה ובצריכת חשמל נמוכה יותר.
ככל שמערכות AI כוללות יותר מעבדים ויותר זיכרון, האתגר להוא לא רק לבצע את החישוב אלא גם להעביר את המידע למקום הנכון בזמן. חיבור איטי יכול להשאיר מעבדים יקרים בהמתנה ולפגוע בניצול המערכת.
חברה נוספת היא ANET שמספקת מתגים ותוכנה לרשתות של מרכזי נתונים. הגדלת אשכולות ההסקה עשויה לדרוש יותר חיבורים, קצב העברת מידע גבוה יותר וניהול חכם יותר של התנועה בין השרתים.
LITE ו-COHR מספקות רכיבים אופטיים, לייזרים ומשדרים שמעבירים מידע באמצעות אור. ככל שהמרחקים והמהירויות גדלים, החיבור האופטי הופך חשוב יותר. החשיפה שלהן נובעת מהצורך להעביר כמויות גדולות של מידע בתוך מרכזי הנתונים ובין אתרים שונים.
השרתים הופכים את הרכיבים למערכת עובדת
Dell מרכיבה את המעבדים, הזיכרונות, האחסון ורכיבי התקשורת בתוך מערכות שרתים מלאות. היתרון שלה הוא ביכולת לספק לארגונים פתרון מוכן, כולל חומרה, שירותים ותמיכה, במקום שהלקוח ירכיב בעצמו את כל שכבות המערכת.
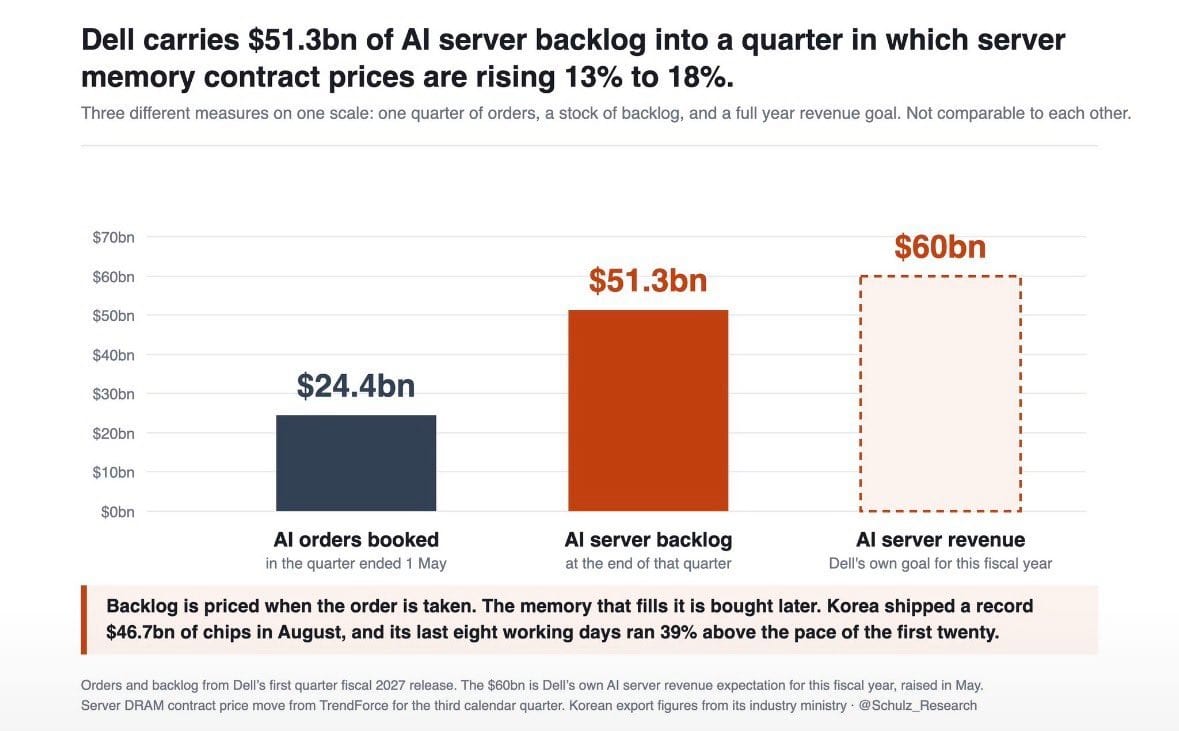
התרשים למטה מציג הזמנות לשרתי AI בהיקף של 24.4 מיליארד דולר ברבעון, צבר הזמנות של 51.3 מיליארד דולר בסוף הרבעון ויעד הכנסות שנתי של כ60 מיליארד דולר.
אלה שלושה מדדים שונים. הזמנות הן הפעילות שנחתמה בתקופה מסוימת, צבר הוא היקף ההזמנות שעדיין לא הוכר כהכנסה, ויעד ההכנסות מתייחס לשנה כולה.
מקור: Schulz Research
חשוב לציין שהנתונים לא מוכיחים שההסקה היא כבר מקור הביקוש המרכזי לשרתים, אך הם מראים שהשקעות הAI ממשיכות להתגלגל להזמנות ממשיות. הסיכון עבור Dell הוא שמחירי הזיכרונות והרכיבים יעלו לאחר שהחברה כבר קבעה את מחיר ההזמנה, דבר שעלול ללחוץ על הרווחיות גם כאשר ההכנסות גדלות.
יותר חישובים יוצרים יותר חום
VRT מספקת מערכות קירור מתקדמות למרכזי נתונים, ובהן פתרונות קירור נוזלי שמעבירים נוזל קירור בצינורות סמוך למעבדים ולשבבים. כך ניתן לפנות את החום ביעילות, לשמור על ביצועים גבוהים לאורך זמן ולהפחית את הסיכון להתחממות ולפגיעה בציוד.
ככל שמכניסים יותר כוח חישוב לכל ארון שרתים, צריכת החשמל וצפיפות החום עולות. קירור אוויר רגיל עשוי שלא להספיק למערכות החזקות ביותר, ולכן מרכזי נתונים עוברים בהדרגה לפתרונות קירור מתקדמים, לרבות מערכות שמוליכות נוזל קרוב יותר למעבדים.
הביקוש לקירור אינו תלוי רק במספר מרכזי הנתונים החדשים. גם שדרוג של מרכז נתונים קיים לציוד חזק וצפוף יותר יכול לדרוש החלפה של מערכות החשמל והקירור.
מהמעבד ועד רשת החשמל
ETN, POWL ו-HUBB מספקות בתמהילים שונים לוחות חשמל, מפסקים, מערכות בקרה, חיבורים וציוד לחלוקת חשמל.
מרכז נתונים לא יכול פשוט להתחבר לשקע קיים, הוא דורש מערכות שמקבלות חשמל במתח גבוה, משנות את המתח, מחלקות את החשמל לציוד ומגינות על המערכת מפני תקלות.
GEV מספקת טורבינות גז וציוד לרשת החשמל. אם הגידול במרכזי הנתונים ידרוש תוספת של תחנות כוח, קווי הולכה וציוד רשת, החברה עשויה ליהנות מהזמנות חדשות ומחוזי שירות.
BE מציעה מערכות תאי דלק שמייצרות חשמל באתר הלקוח. הפתרון יכול להיות רלוונטי כאשר מרכז נתונים רוצה להתחיל לפעול לפני שרשת החשמל המקומית מסוגלת לספק את מלוא הקיבולת הנדרשת. החשיפה תלויה בעלות, בזמינות הדלק, בדרישות סביבתיות וביכולת הפתרון להתחרות באפשרויות אחרות.
PWR פועלת בהקמה ובשדרוג של קווי הולכה, תחנות משנה וחיבורי חשמל. היא אינה מרוויחה ישירות מכל טוקן שמעובד, אך היא עשויה לקבל יותר פרויקטים אם הגידול בביקוש לחשמל יחייב הרחבה משמעותית של הרשת.
יצרניות החשמל הן חשיפה מקומית יותר
CEG, VST וNRG עשויות ליהנות מגידול בצריכת החשמל, מחוזים ארוכים ומעלייה בערך של ייצור זמין באזורים שבהם הביקוש גדל מהר מההיצע.
עם זאת, לא כל יצרנית חשמל נהנית באותה מידה. ההשפעה תלויה במיקום תחנות הכוח, במבנה שוק החשמל המקומי, בחוזים, בעלויות הדלק ובמדיניות הגידור. תחנת כוח באזור שבו אין קיבולת הולכה פנויה או שבו לא נבנים מרכזי נתונים אינה נהנית אוטומטית מהגידול הארצי בביקוש.
לכן החשיפה של חברות החשמל להסקה רחוקה יותר מזו של יצרניות המעבדים. היא יכולה להיות משמעותית, אך היא תלויה בהרבה יותר משתנים מקומיים ורגולטוריים.
לסיכום, האימון היה רק ההתחלה
המעבר מאימון מודלים לשימוש יומיומי בהם עשוי להפוך את ההסקה למנוע הביקוש הבא של תשתיות הAI. ככל שמספר המשתמשים והסוכנים גדל, כך נדרשים יותר מעבדים, זיכרון, אחסון, תקשורת, שרתים, קירור וחשמל.
כאמור, ההזדמנות שלנו כמשקיעים מאוד רחבה, החל מNVDA וAMD שמבצעות את החישובים ועד VRT, ETN, PWR ויצרניות החשמל שתומכות בתשתית הפיזית.
עם זאת, יותר טוקנים אינם מבטיחים גידול זהה בהכנסות, משום שהיעילות ממשיכה להשתפר והחשיפה של כל חברה שונה. התזה המרכזית היא שהשימוש בAI יצמח מהר יותר מהחיסכון במשאבים הנדרשים לכל פעולה. אם זה אכן יקרה, ההסקה עשויה להאריך את גל ההשקעות בתשתיות AI הרבה מעבר לשלב אימון המודלים.